

微秒级光交换,毫秒级现实
从 SDN 编排到设备执行,重算 OCS 控制路径的时间账
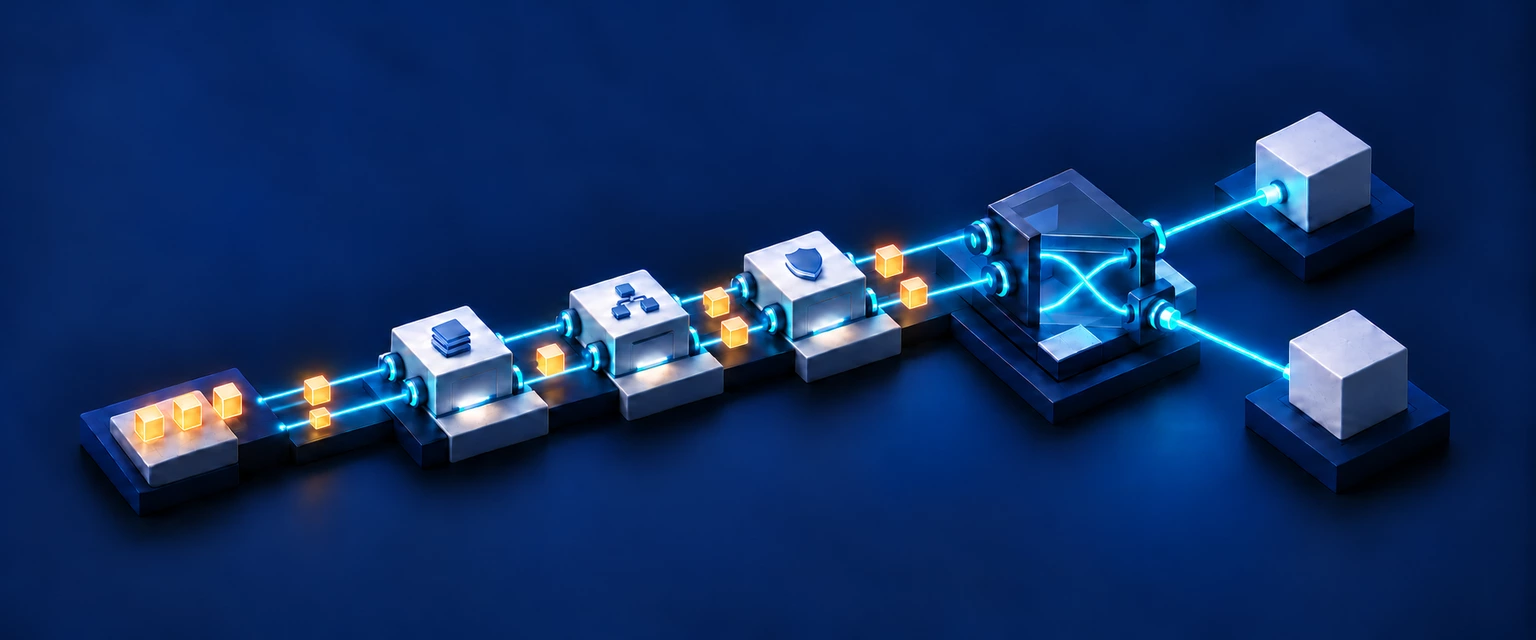
光路交换机(Optical Circuit Switch,OCS)正在跨过毫秒级重构的门槛。2025 年 3 月,OFC 展会前夕,iPronics 发布 ONE-32,将它称为“全球首款基于硅光的 OCS”,并给出小于 300 μs 的快速重构承诺,微秒级切换由此成为面向数据中心的产品卖点。2026 年 9 月,iPronics 又宣布完成 1.25 亿美元 B 轮融资,NVIDIA 参与其中,支持其面向 AI 数据中心的光网络商业部署。
更快的切换,意味着光交换可以赋能更多应用。 在 2026 OCP 全球峰会(OCP Global Summit)的 Fast switching OCS for AI and Hyperscale Data Centers: Benefits, Technologies and Emerging Applications 中,Lumotive 的 James Burch 与 iPronics 的 Vivek Sarathy 用“Faster Switching Expands its Use Cases”概括这一变化:当重构进入亚毫秒级,光连接就有机会随流量需求和 AI 通信阶段更频繁地调整,服务于动态流量疏导、阶段间拓扑适配和更细粒度的光路调度。速度的意义,在于让原先受重构等待限制的用法变得值得探索。
与此同时,围绕既有 SDN 体系统一模型、接口和多厂商编排,已成为当前 OCS 集成工作的重点方向。 这条路线可以复用成熟的网络管理能力,但当重构需要跟上应用的通信阶段时,也需要重新检查原有控制流程的时间假设。iPronics 的 Iwan Kartawira(OCP OCS 子项目负责人之一)与 KDDI 的 Kazuaki Ueda 在 Optically-Accelerated AI Clusters Enabled by Interoperable Multi-Vendor OCSs: Use Cases and Opportunities 中明确提出“CPO + OCS + SDN”,将工作负载优化放在 SDN 与 OCS 协同的架构中;其多厂商控制路径由 gNMI 客户端进入设备的 gNMI 服务与通用 YANG 数据存储,再对接厂商 API。统一模型、控制器与既有管理协议,构成了这条集成路线的骨架。
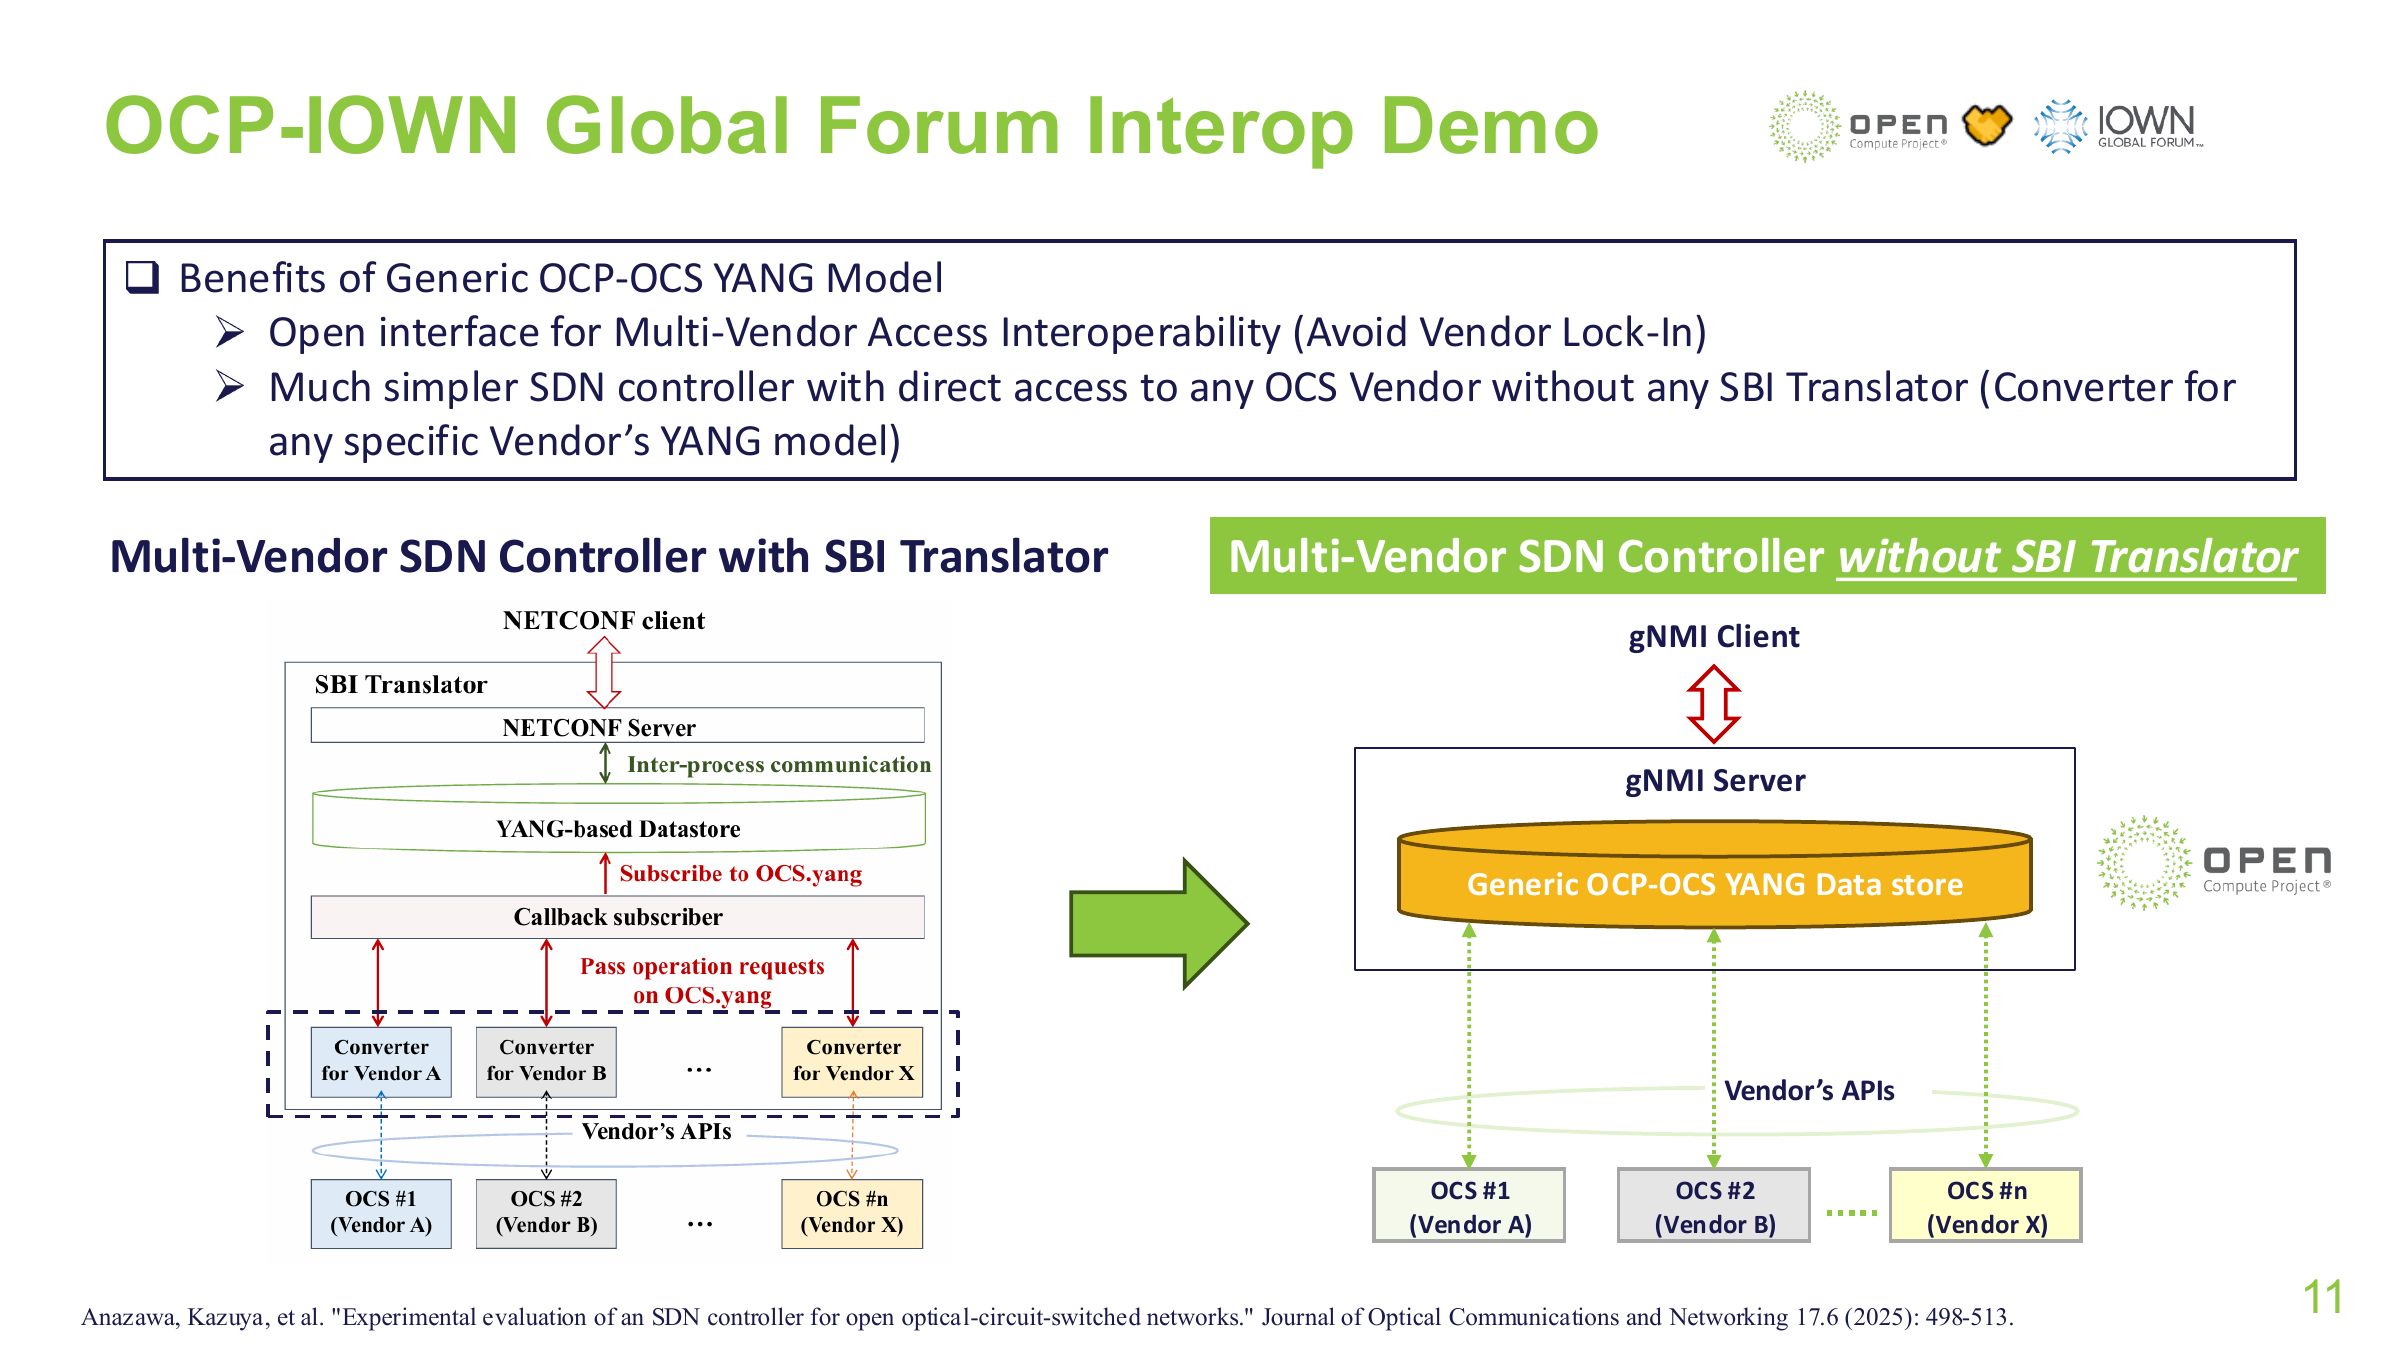
但当 OCS 要随通信阶段频繁重构时,完整沿用面向电交换网络的 SDN 控制流程,可能让控制路径成为重构速度的主要限制。 在逐次经控制器协调的实现里,应用先请求控制器,控制器协调资源,再调用设备代理(OCS Agent);设备实现还可能通过本地服务和 SDK 执行操作。全局管理和厂商适配各有价值,但每一跳也会引入额外的通信、校验、调度和排队。
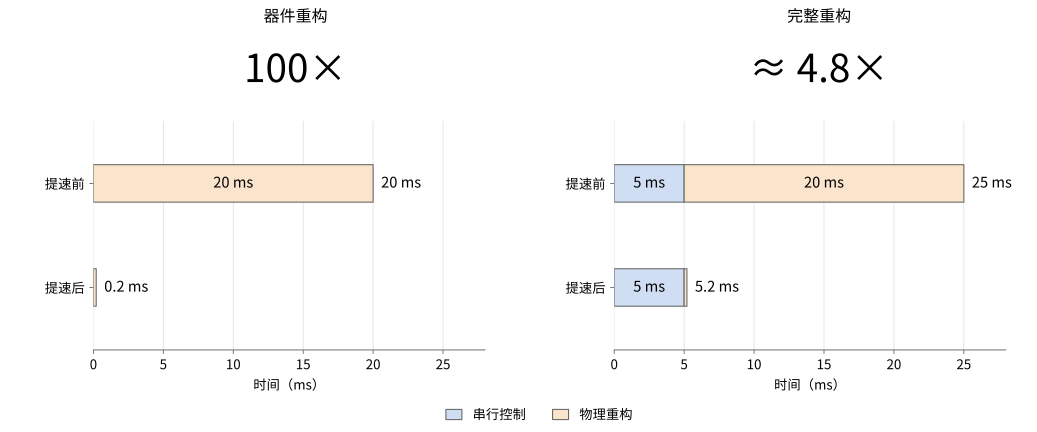
以传统 3D MEMS 的毫秒级向硅光的亚毫秒级演进为背景,考虑这样一笔账:假设 OCS 物理重构从 20 ms 降到 200 μs,串行控制路径仍需 5 ms,完整重构的等待就从 25 ms 降到 5.2 ms。器件快了 100 倍,整体只快约 4.8 倍。 当控制架构仍按较慢的配置周期组织,每次执行却需要跟上通信调度时,沿用的控制路径就会吞掉器件迭代带来的大部分提速空间:器件已进入微秒级,完整重构仍停留在毫秒级。
上面算例中的落差,根源在于控制架构与快速重构使用方式的不匹配。 在典型的 SDN 电分组网络中,集中式控制器负责全局资源协调和规则配置,交换机硬件负责持续转发。这种架构兼顾了集中管理与高速转发:一次配置可以服务大量后续通信,控制成本得以摊薄,因此通常对单次配置开销相对不敏感。
而对于随通信阶段频繁重构 OCS 的应用,连接配置直接决定下一阶段何时能够发送数据。如果仍让每次重构经过完整的远程协调和设备配置流程,原本可以摊薄的控制成本,就会成为每轮通信必须支付的等待。直接沿用这种配置流程,会使控制架构与 OCS 快速切换场景产生严重的时间尺度错配。 回到算例:物理重构已经压缩到 200 μs,5 ms 的控制路径却原封不动,成本结构完全倒置——等待的大头不再是器件动作,而是控制软件本身。
OCP 社区正在推动统一模型、多厂商互操作和端到端指标,而本文要追问的是:当配置成为每轮通信的必经步骤,现有控制架构是否还合适,又该怎样调整分工和执行路径?
一次重构:从规划决策到设备执行
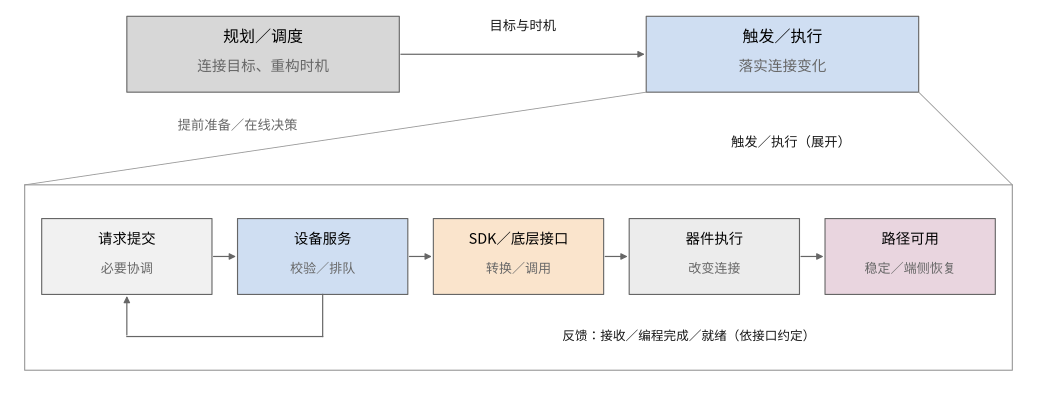
把 OCS 集成到网络中,首先要决定连接哪些端口、什么时候改变连接,以及怎样与应用的通信阶段配合;随后,系统需要把这个决定交给设备,并完成实际重构。前者属于拓扑规划与调度,后者属于触发与执行。规划可以提前完成,执行在需要时触发。 目标可预测时,可以先算好连接;随需求到达才确定目标时,则需要在线决策。本文关心的是:目标已经确定以后,系统还要走多长的执行路径,才能让应用用上它?
执行通常从一条连接请求开始:请求经过必要的协调,到达设备控制服务;设备软件检查目标与权限,调用 SDK 或底层控制接口,把端口连接转成可执行的器件状态。不同 OCS 在这里有不同实现。
Google 的 Mission Apollo 描述了一个具体的 MEMS 例子:CPU 接收端口连接命令,经 FPGA 和高压驱动板设置微镜电压,再利用相机反馈调整镜面,使光路达到合适状态。
对于可编程硅光网格,目标还需要映射成内部路径和可编程单元的状态; 就将高层程序转为图表示,再求解它到目标光子硬件的映射。
理解设备报告的结果,需要先区分四个时刻:收到请求、编程完成、光路稳定、应用可用。下图展示这些职责及其依赖。
时间预算:器件之外,还要等多久?
有了这个框架,开头提到的那 5 ms 控制开销就可以继续拆开。先考虑一个串行场景:应用知道目标后发起请求,设备执行重构,端侧等路径就绪后再开始下一轮通信。把时间轴上互不重叠的工作区间写成:
T_ready = T_request + T_service + T_apply + T_settle + T_endpoint-
T_request:请求准备、去程通信及必经的控制器处理。 -
T_service:设备服务接收、校验、排队和内部交接。 -
T_apply:把目标转为设备操作,并调用底层接口。 -
T_settle:接口调用后仍需等待的物理稳定。 -
T_endpoint:其余端侧恢复,以及应用必须等待的完成通知。
实际实现若有重叠,就应按依赖图的最长路径计算。例如,SDK 已经等待微镜稳定时,不能再额外加一份完整的物理动作时间;端侧恢复与器件动作并行时,也不能简单累加。这个模型的作用,是找出应用真正需要等待的工作,而不是给每个软件层都记一笔包含下游调用的总时长。
暂时忽略端侧恢复,将串行控制成本记为 C、物理重构记为 P,就回到开头的 T_ready = C + P。同样的器件提速,遇到不同的控制路径,会得到不同的完整重构时间:
物理重构 P = 20 ms:
| 串行控制 C | 总等待 C + P | 控制占比 |
|---|---|---|
| 5 ms | 25 ms | 20.0% |
| 500 μs | 20.5 ms | 2.4% |
| 100 μs | 20.1 ms | 0.5% |
物理重构 P = 200 μs:
| 串行控制 C | 总等待 C + P | 控制占比 |
|---|---|---|
| 5 ms | 5200 μs | 96.2% |
| 500 μs | 700 μs | 71.4% |
| 100 μs | 300 μs | 33.3% |
两表的控制占比均按 C / (C + P) 计算。同样的控制成本,在器件提速后会占去更多等待。
控制路径上的等待,如何累积到毫秒?
请求与回复在网络中的传输,可以先按字节量估算。假设两者各有 1 KiB 有效载荷,每方向另留 128 B 封装预算,经过两台存储转发交换机、三段链路:无重传时,双向串行化在 1 Gb/s 下约需 55 μs,在 10 Gb/s 下约需 5.5 μs,传播与转发另计。
但字节到达以后,请求还要经过端点处理、设备内部交接和底层接口调用。考虑一个连接已预热、负载较低的例子:客户端向设备服务发起一次连接请求,独立执行进程(Worker)先调用底层接口删除受影响的旧连接表项,等待返回,再调用底层接口安装目标表项,最后回复客户端。 这里一次应用请求包含删除、安装两次底层提交;每次提交都可以批量处理多条表项。参考现有电交换设备软件栈的开销量级,可以列出下面这份假设预算(它采用上述先删除、再安装的实现方式,不是某款 OCS 的通用参数,也不是实测统计区间)。
| 一次同步请求的组成 | 示例预算 | 包含的工作 |
|---|---|---|
| 请求与回复的网络传输 | 10–80 μs | 串行化、传播与交换转发,不含端点软件 |
| 客户端与设备北向处理 | 0.5–1 ms | 收发、编解码和请求分发,不含网络传输 |
| 设备内部交接与非编程工作 | 0.5–2 ms | Worker 交接、校验、排队和状态处理,不含底层调用 |
| 删除、安装分两次底层提交,合计 | 3–4 ms | SDK client、底层 RPC、运行时处理与调用内等待 |
| 合计 | 约 4–7 ms | 无独立控制器、有 Worker,删除、安装串行提交 |
这条示例路径沿用了常见 SDN 设备软件栈中的接口处理、独立执行进程和底层调用,即便尚未加入独立全局控制器,控制成本也已达到约 4–7 ms。 相对于数百微秒的物理重构,这些软件工作会成为等待的主导项。要让控制路径跟上器件速度,就需要重新检查各环节的职责与实现:哪些协调必须在线进行,哪些接口能力需要逐次提供,哪些设备操作可以减少交接或并行完成?
架构选择:三个可以分别取舍的维度
沿着一次请求从应用到设备的执行路径,可以依次提出三个问题:是否需要全局控制器逐次协调,用什么接口进入设备,以及设备内部怎样执行。它们对应三个可以分别取舍的设计维度:① 控制器参与方式、② 控制接口与协议、③ 设备执行架构。 比较时既要看能力是否必要,也要看能否换一种实现方式,在预算内提供这些能力。
| 设计维度 | 可选择的实现 | 主要取舍 |
|---|---|---|
| ① 控制器参与方式 | 集中协调执行/授权后由任务直接提交(fast path) | 全局协调与局部自主控制的边界 |
| ② 控制接口与协议 | 通用 RPC/轻量请求—响应协议 | 工具与协议能力、处理成本及维护责任 |
| ③ 设备执行架构 | 软件:独立 Worker/同进程适配; 器件:逐项驱动/批量提交与多通道控制 | 隔离与交接、配置传输效率、并发能力与反馈依赖 |
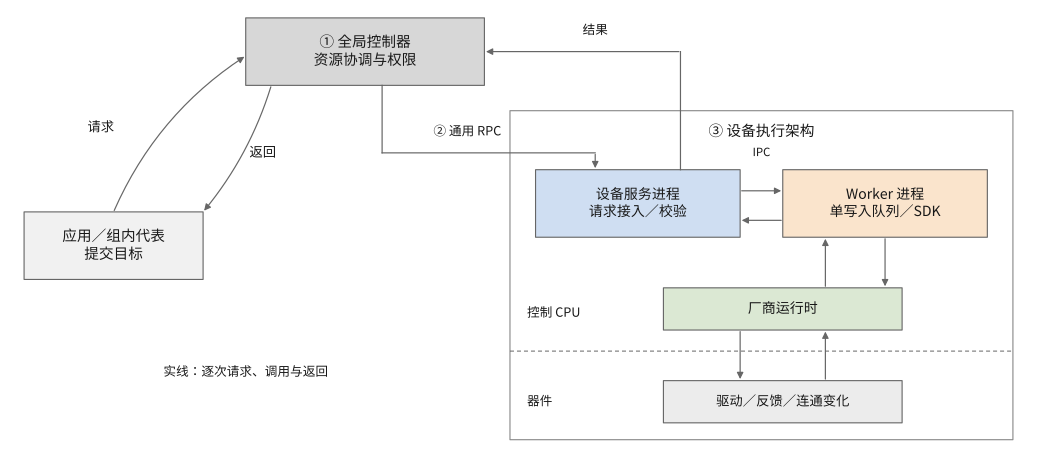
三个维度不必一起换边:可以保留通用 RPC,同时允许授权范围内直接提交;也可以换用轻量协议,但继续保留独立 Worker。下面分别估算这些选择可能影响的量级。
① 控制器参与方式:集中协调,还是下放局部控制权?
如果重构涉及全网资源,集中协调就有直接价值。例如 Google 的 Jupiter Evolving 将 OCS 拓扑调整与集中式 SDN 的流量工程结合,连接决策需要考虑全网流量与拓扑。另一类场景则不同,假设一个通信组在租约有效期内独占一组端口,局部连接变化不会影响其他作业,控制器可以先确定资源边界,组内代表再直接向设备提交,在单个任务范围内让连接拓扑匹配工作负载的通信阶段。设备仍检查权限、目标和版本,阻止过期执行者继续写入;控制器仍负责监督、回收与故障恢复。全局状态需要统一管理,并不意味着每次已经获准的局部操作都必须再经过同一个远程执行者。
后一种分工省掉了重复经过控制器的通信、排队与处理,设备侧必要的校验仍然保留。它也要求系统能够应对代表失效、租约撤销,以及请求结果不明时的接管与状态核对。若资源边界无法提前划清,在线仲裁就不能省略;若能够划清,这一跳便可以从执行路径上移走。
先估算一个量级:若逐次协调比直接提交多出 100 μs 的交互开销、200 μs 的处理与排队,且这些工作无法重叠,提前授权就有机会从执行路径上移走约 300 μs。对只允许数十 μs 控制成本的场景,这一跳本身就值得重新安排;具体能否省下,还要看直接提交新增多少设备工作。
② 控制接口与协议:通用 RPC,还是轻量请求—响应?
设备管理需要丰富对象、遥测和成熟工具,通用 RPC 能够复用这些能力;一次时间紧迫的重构,可能只需表达目标连接、授权信息、版本和完成结果。如果通用接口的处理成本满足预算,保留它有利于维护和集成。如果这部分成本已经不可忽略,也可以为执行另设更窄的接口,让 YANG 继续描述连接与状态,gNMI/gRPC 继续承担管理职责。
我们探索过一种轻量请求—响应接口:以长度前缀划分消息,用 protobuf 表达请求与响应;应用与设备之间使用持久 TCP,设备内部交互使用 Unix 域套接字(Unix Domain Socket,UDS)。它减少了一部分通用 RPC 处理,但错误、超时、重连和背压仍需实现者处理。gRPC 基线同样复用连接;这条轻量接口也不提供 gNMI 的完整协议能力。
假设连接、负载和线上传输保持不变,每段完整请求—响应的两端协议处理合计从 200 μs 降到 100 μs,那么一段可省约 100 μs,两段串行交互约省 200 μs。
③ 设备执行架构:从软件交接到并行控制
③a 软件组织决定请求要经过多少次交接。 接口接收、语义校验和 SDK 适配是不同职责,但是否需要各占一个进程,要由隔离收益与时间预算共同决定。独立 Worker 可以隔离语言运行时和 SDK 故障,也会增加编解码、socket、线程唤醒和排队。同进程适配可以减少交接,但要求语言与 SDK 支持,也会扩大故障影响范围。职责边界值得保留,进程边界需要说明它换来了什么。
这类软件交接在电交换系统中已有广泛实践,SONiC、Stratum 等白盒交换机软件就是例子。SONiC 已用于大型云服务商的生产数据中心;在其典型路径中,
orchagent经 Redis 状态传递与syncd衔接,后者调用厂商 SAI/SDK。这种组织支持模块解耦和硬件适配,也增加了状态转换、通知与进程唤醒。SONiC 社区的大型数据中心路由优化方案报告,在大规模路由场景中,每条路由的多次串行 Redis 操作会增加约 500 μs–1 ms 延迟,并讨论用 ZMQ 减少关键路径上的 Redis 操作。这是该方案报告的场景量级,并非所有 SONiC 配置的固定开销。
若一次内部往返本身需要 30 μs,额外消息包装和线程投递再需 200 μs,而内联调用新增工作可以忽略,合并这次交接便可能减少约 230 μs。两种实现都需要协调对设备的写入,避免并发请求相互覆盖。
减少软件交接之后,还需要继续检查器件执行:一个连接目标究竟要经过多少步操作,才能落实为实际连通?
③b 器件控制决定一个目标要分几步落实。 一条逻辑连接可能涉及多个 MZI 的相位设置,或两侧多个 MEMS 微镜的姿态调整。把多个操作合进一条命令,可以减少提交成本;设备是否同时装载、同时驱动这些执行器,以及需要几轮反馈才能达到稳定,则是更下一层的能力。调用次数少,不等于器件已经并行执行;并行启动,也不等于同时完成。
Apollo 给出了阵列级控制的例子:CPU 经 FPGA、高压驱动和 DAC 设置 MEMS,反馈相机为每个微镜阵列拍摄图像,伺服系统据此调整多个微镜。
硅光中的多个调节单元也可以同时工作,但连接经过的各级单元可能相互依赖:前一级还没调好,后一级就无法完成校准。
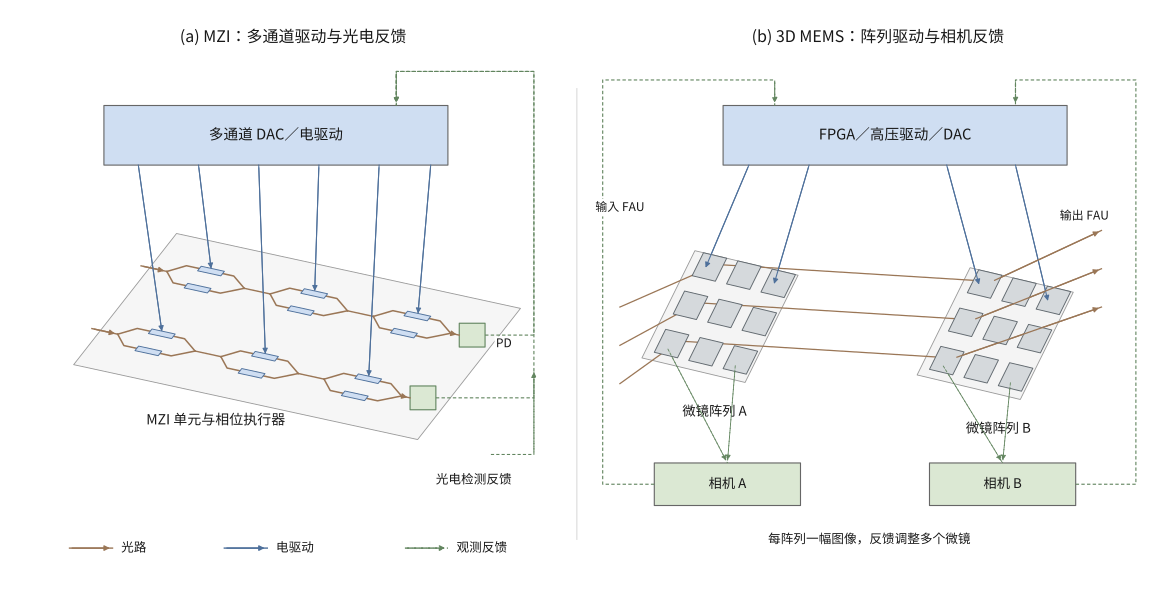
因此,设备内的执行时间可以继续拆成:命令提交、配置装载、沿依赖轮次收敛,以及最终确认。在每个可独立并行的轮次中,等待由相关通道中最晚完成者决定;轮次之间存在依赖时,还要继续等待。
把三个选择组合成一种候选分工
考虑这样一类快速重构场景:资源能够提前分配,设备可以校验授权,SDK 又允许同进程适配。一种值得检验的候选分工是:控制器提前完成资源协调,之后只负责授权、监督与回收;组内代表通过轻量请求—响应协议直接提交;设备在同一进程中完成校验与 SDK 适配,经单写入队列把批量目标交给厂商控制栈;最后由设备按自身驱动并发度和反馈机制落实目标,按约定报告结果。与图 4 相比,这个组合在三个维度上都取了精简端,但它只是众多组合之一——也可以只换其中一项,其余维持原状。
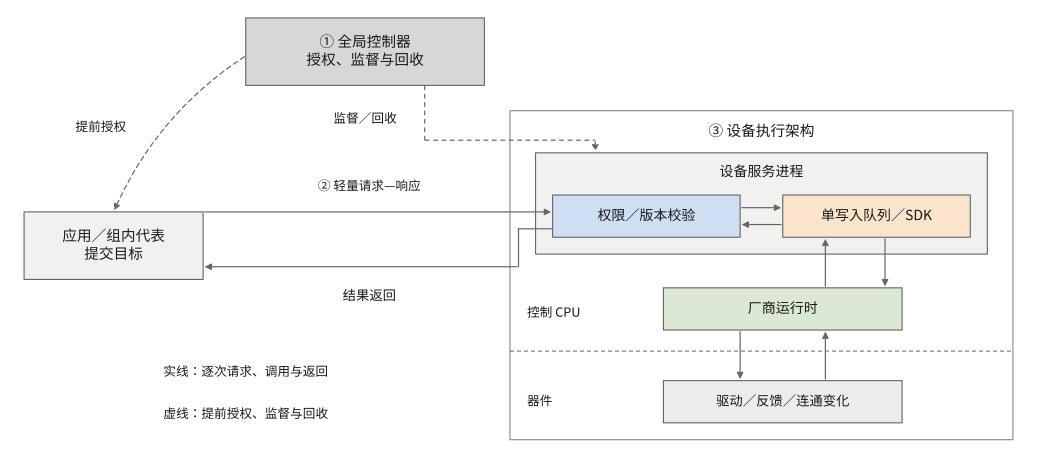
沿着两幅架构图,可以检查哪些工作提前完成了,哪些交接合并了,哪些设备成本仍然存在。下面先说明实验平台,再看现有证据能支持哪些判断。
实验平台:用 Intel Tofino 交换机模拟连接变化
真实 OCS 改变端口之间的光路;ReconfigNet-Sim 则使用 Intel Tofino 可编程交换机,通过改变哪些端口对能够传包,模拟连接关系的变化。 具体来说,P4 流水线先确定候选出口,再查询入口与出口之间的许可表:匹配当前连接关系的包才能通过。更新这张表,就能让原有逻辑连接断开、新连接生效,为调度器和控制软件提供可反复修改与观察的平台。
例如,应用请求把连接从 A—B 改为 A—C,设备就要撤销旧连接的转发许可,并安装目标连接的许可。应用只发起一次连接请求;设备服务可以先向底层接口提交删除旧许可的操作,等待返回,再提交安装目标许可的操作。 下文把这种方式称为“删除、安装分两次提交”;把两类操作放进同一底层请求,则称为“合并为一次提交”。每次提交都可以包含多条表项,次数指设备服务调用底层接口的次数。
两侧的控制链路也有可比较之处:应用提交连接目标,设备代理检查并转换,再调用厂商接口执行。ReconfigNet-Sim 中的 Agent 经 BFRT 客户端和厂商运行时 bf_switchd 修改许可表,因此能够测量软件处理、内部交接和设备调用,并用实际传包检查效果。
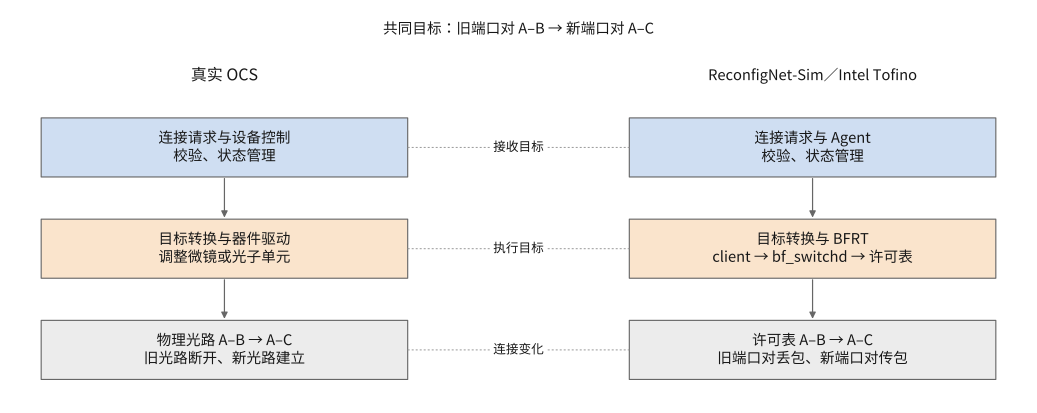
这里模拟的是逻辑连通:电链路始终在线,P4 也会解析和处理分组。光功率稳定、误码率(BER)、物理层链路训练和网卡恢复,仍需真实光器件验证。下文采用物理 Intel Tofino-1 上的既有测量,范围遵循项目边界说明。
实验观察:沿控制路径改造,等待怎样缩短?
本节固定采用前文 fast path 的直接提交方式:客户端直接向设备服务发送连接目标,设备保留权限、目标与版本检查。 实验没有比较“控制器参与方式”,也没有测量逐次经过独立控制器的成本。在这一前提下,下面沿图3的请求执行顺序,依次看 ②控制接口与协议、③a设备服务的软件交接、③b底层接口调用;最后持续发包,检查新路径何时开始传包,以及切换期间通信中断了多久。
计时从客户端发起请求到收到成功回复,记为T_API;其中的 SDK 编程区间记为T_SDK,包含 SDK 客户端处理、底层 RPC、厂商运行时及调用内等待,对应前文T_apply中的底层接口工作。SDK 之外的区间由每次请求相减后统计,包含上层处理和通信,不能直接相减两个 p99。本机诊断帮助解释成本,完整路径的改造效果由外部客户端跨机验证。
控制接口与协议:精简请求—响应路径
先看请求怎样进入设备。前文区分了通用管理接口与时间紧迫的连接执行:后者主要需要表达目标连接、授权信息、版本和完成结果。围绕这些必要内容,我们尝试了轻量请求—响应协议,用长度前缀划分消息、protobuf表达请求与响应,在持久 TCP 连接上传输;在保留独立执行进程的轻量接口实现中,设备内部交互也采用同样的消息封装,经 UDS 传递。
这项调整的目的是减少通用 RPC 框架中的协议处理与请求分发。两种接口都复用连接;轻量接口仍需处理错误、超时、重连和背压。映射到 OCS 集成,这对应前文②的选择:在保持执行所需语义的前提下,检查接口的通用能力会在每次重构中引入多少处理工作。
请求进入设备后,还要经过服务内部的校验、转换和底层适配。这些环节与协议处理一起影响等待,因此下面继续检查设备服务,并在同一组跨机结果中观察它们共同调整后的效果。
设备服务:减少跨语言、跨进程的软件交接
外部请求端采用 Golang,贴近常见网络控制面的实现方式;设备侧接收网络请求的接口服务,也用 Golang 实现。 设备侧最初沿用厂商的 Python 示例与 BFRT 客户端,形成 Golang 接口服务+Python 执行进程的分工:前者接收并校验连接目标,后者把它转成底层操作。两者都在设备控制主机上,合起来承担前文设备 Agent 的职责。
这套分工便于接入已有示例,但一次连接目标也需要跨语言、跨进程传递。为减少③a所说的软件交接,我们依据公开的bfruntime.proto生成接口代码并实现 Golang BFRT 客户端,把接口服务、校验与底层适配放入同一进程,继续连接原有厂商运行时bf_switchd。
合并进程减少了消息传递、线程唤醒与调度;更换客户端则减少了部分请求构造和编解码工作。本平台旧版 Python 与纯 Python 协议库需要逐项解释并处理动态对象,Golang 的编译代码可以减少其中的用户态处理。这些工作分布在接口服务与 SDK 客户端两侧,因此调整软件组织,也可能改变 SDK 编程区间的耗时。
历史本机诊断帮助解释了这部分成本:约800 MHz、删除与安装仍分两次提交时,从 Golang 服务+Python 执行进程,改为 Python 单进程、再到 Golang 单进程,SDK 之外的均值由约 1003 μs,经667 μs,降到303–307 μs。继续精简客户端处理,并调整控制 CPU 主频至约1.2 GHz及更换构建版本后,这部分又降到约 140 μs;这时尚未合并底层提交。
完整跨机路径上,轻量协议与同进程适配组合,使 API 等待均值从3777降到1069 μs。图8的跨机对照采用同一外部客户端与管理网路径,设备控制 CPU 采用相同的 performance 策略、两个固定核心,主频约1.6 GHz。注意,这里同时改变了北向协议、内部交接和 BFRT 客户端实现,结果反映整套路径的差异。
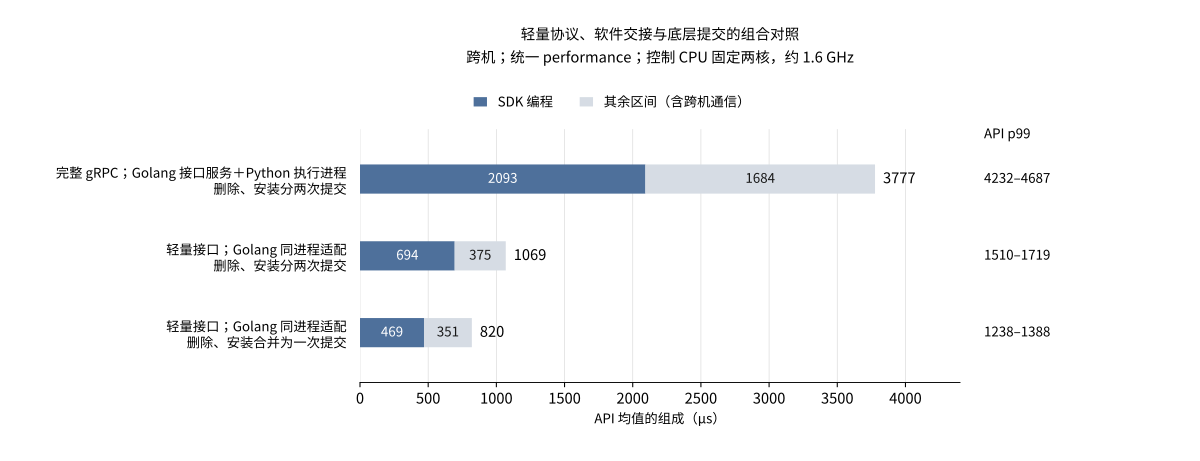
对真实 OCS 的集成,这对应设备服务内部怎样组织执行:目标转换、进程间传递和请求编解码,都会进入每次重构的时间预算。软件层次的调整需要同时检查服务与客户端库,才能判断哪些工作仍是请求必须等待的。
底层接口:减少提交次数,检查剩余等待
请求已经更快到达底层接口,接下来要问③b中的问题:完成一个连接目标,需要多少次串行设备操作? 本平台原实现把删除旧许可、安装目标许可分成两次 BFRT 提交,每次都要等待bf_switchd返回。服务已经知道完整目标,便可把删除、安装操作合并到一次批量请求中,减少一次底层接口往返。
图8中同一版 Golang 跨机候选的 API 均值进一步从1069降到820 μs,SDK 编程从694降到469 μs。从原结构到最终候选,完整 API 均值减少约 78%,约快4.6倍;最终各次重复的 API p99 为1238–1388 μs。
图9的本机诊断进一步说明剩余成本:当 SDK 之外已降到约140 μs,合并为一次提交后,SDK 仍约491–496 μs,完整 API 均值约632–634 μs,设备接口路径占比接近78%。注意,这个占比属于本机诊断配置;完整跨机候选的 SDK 均值约469 μs、占比为 57%,其余区间约351 μs。其余区间的 p99 为 492–527 μs。
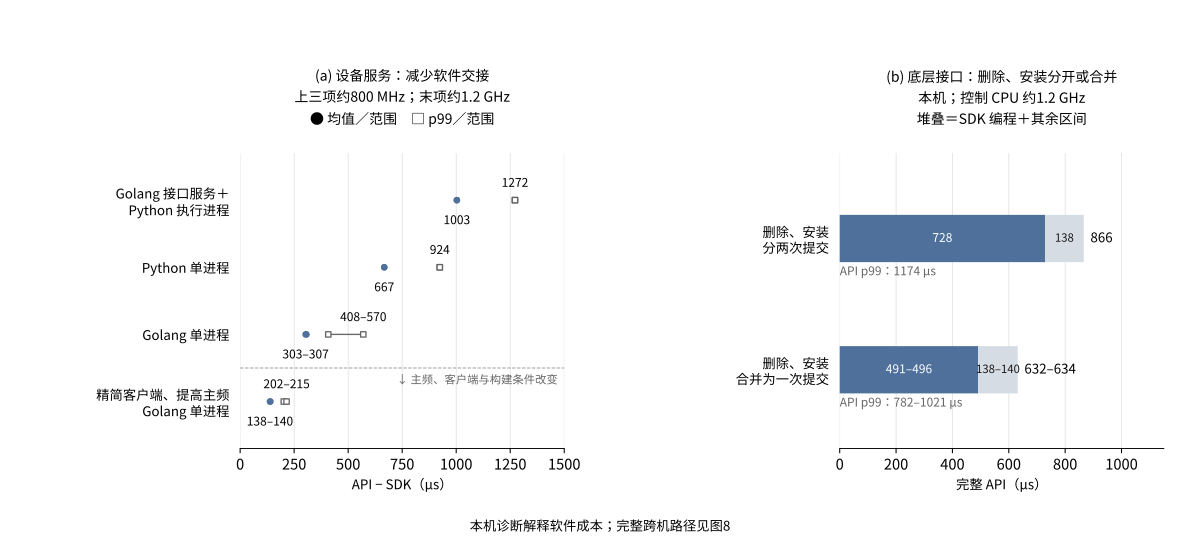
随着上层协议处理和软件交接缩短,设备接口路径成为最大的单项等待。映射到真实 OCS,继续提速需要整机厂商与集成方共同优化设备控制接口及运行时。 集成方可以减少目标转换、请求包装和重复提交;厂商需要检查运行时怎样接收目标、推进设备执行、报告完成。器件的切换速度能否被系统及时用上,也取决于这条控制路径的效率。
本实验通过合并请求减少了接口步骤。对于真实 OCS,整机接口能否接受完整连接目标、支持哪些批量操作,会影响系统需要支付多少次往返;器件内部能否并行执行、何时达到可用状态,则需要进一步检查设备能力与完成语义。
控制请求变快之后,实际转发何时完成切换? 在上述接口计时之外,另做一组持续发包的实验,观察从请求发出到收到新路径首个回包需要多久(T_visible),以及旧路径最后回包到新路径首个回包之间的切换空窗。前者反映目标连接何时开始可用,后者反映通信中断了多久。
| 数据面观测(p99) | 原分进程路径,删除、安装分两次提交 | Golang 同进程,删除、安装分两次提交 | Golang 同进程,删除、安装合并为一次提交 |
|---|---|---|---|
请求至首个新路径回包 T_visible | 4000 μs | 1695 μs | 1539 μs |
| 切换空窗 | 3113 μs | 1460 μs | 1180 μs |
同组汇总中,新路径首次可见的 p99 改善约61.5%,切换空窗的 p99 改善约62.1%。这说明控制路径的改造也改善了实际转发切换。实际探针间隔的 p99 为49–58 μs,观测包含探测和收包调度;改善后的 p99也不足以保证每次切换都满足应用预算。
本节验证控制接口、设备服务与底层提交的改造;真实 OCS 还需验证光路稳定与端侧恢复,才能检查应用可用的完整预算。
从控制预算到系统设计:给业界的建议
快速 OCS 的系统设计,应从应用允许的等待时间反推控制职责、接口和设备执行方式。 前文的改造已经说明,控制软件能够决定器件速度有多少最终到达应用。接下来,系统集成方、整机厂商与标准组织都需要把这笔时间账落实到各自负责的接口和实现中。
按应用预算组织执行路径
把应用何时需要路径、什么事实算就绪,作为控制架构的设计输入。 低频拓扑调整可以摊薄配置成本,逐通信阶段重构却会在每轮通信前支付这笔等待。后者需要一条按预算组织的执行路径:资源能够提前划定时,控制器先完成授权与协调,任务在授权范围内直接提交;设备保留在线权限、版本与目标检查。沿前文三个设计维度,继续压缩协议处理、软件交接和设备操作,把能够提前完成的工作移出触发时刻。
| 控制预算 | 目标随请求才确定 | 目标可以提前准备 |
|---|---|---|
| 较宽,例如允许数 ms | 优先满足通用管理与隔离需求,再核验完整路径耗时 | 按收益选择提前准备,避免准备成本超过实际需要 |
| 较紧,例如只允许数十至数百μs | 精简在线协调、协议处理与软件交接,检查 SDK 和尾延迟 | 提前生成、转换和装载配置,执行时选择并激活;设备须支持对应能力 |
这张表应落实为具体的工作分配。系统集成方要列出每次请求仍需完成的协调、校验、转换、装载与反馈,逐项说明为何必须在线执行。已知通信阶段的目标可以提前生成;共享资源发生冲突时,必要的在线仲裁仍要进入预算。控制器继续负责全局资源决策、授权、监督与回收,fast path 的作用是缩短已获准操作的执行路径。
软件路径的时间下限:把微秒预算落实到具体工作
按必需工作与依赖估计软件路径的下限,并用完整路径的尾延迟检查实现。 前文本机软件区间从约300 μs继续降到约140 μs,说明实现与运行条件仍有调整空间;这些观测是当前配置的成本,不能作为通用 CPU 的固定下限。
微秒级通信已有参考:eRPC在同一机架交换机下两节点、32 B 消息、CX5 以太网平台上测得约2.3 μs的 RPC 中位延迟。将20 μs作为整条软件路径待验证的 p99 预算,就要把解析、校验、转换、调度与必要交接共同纳入这笔账。2.3 μs的中位数提供通信量级参考,整条控制路径能否满足20 μs的 p99仍需验证。
软件实现首先要减少重复解析和内存分配、复用已完成的目标转换,并缩短线程与进程之间的交接。对于触发时仍必须执行、且语义稳定的解析、局部校验和状态推进,再评估下沉到设备或 FPGA,让控制 CPU 保留策略与异常处理。加速对象应由关键路径决定,并通过完整调用、状态一致性与故障恢复验证收益。跨越 SDK、运行时和设备边界后的等待,还要继续追踪设备调用与完成机制;Sato 的光交换教程可作为进一步阅读。
整机厂商应把控制路径性能作为产品能力交付
从接收连接目标到编程完成、再到光路可用的耗时,应与器件切换指标一起交付。 前文跨机候选的 SDK 区间仍占 API 均值约57%,包含客户端、底层 RPC、厂商运行时及调用内等待。这说明上层精简之后,系统优化还必须继续进入设备接口路径。整机厂商与集成方要共同明确:一个完整连接目标需要多少次串行调用,每次调用做了什么,哪些等待能够合并或消除。
整机接口应接受完整连接目标或批量操作,减少主机逐项提交和等待;同时提供明确的完成通知与必要的状态读回。厂商还应说明配置装载带宽、执行器并发能力和反馈依赖,使集成方能够判断一次目标需要经过几步才能落实。接口成功返回所确认的事实必须清楚:收到请求、完成编程与光路稳定,各自决定系统下一步能够做什么。
对于可预测的通信阶段,把配置准备与激活分成两个接口阶段:提前生成并装载候选状态,执行时通过短命令、本地事件或约定时刻激活。接口同时定义候选状态的容量、取消与失效规则;定时激活还须给出时钟偏差和触发精度。预装载把配置传输移到触发之前,器件执行与稳定仍需要预算。上述能力应由厂商实现并验证,成为应用能够使用的设备能力。
把时间指标与完成语义写进互操作要求
共同模型与接口还应配套共同的时间指标、完成语义和验收方法。 OCP 材料已经呼吁端到端指标与共同服务语义;OCP、ODCC 等社区应进一步将这些目标落实到可比较、可验证的接口要求。
呼应图3,规范应区分收到请求、编程完成、光路稳定和应用可用四个时刻,约定各项测量的起止点。设备报告编程与光路状态,系统继续检查端侧恢复和实际通信条件,最终对应前文的T_ready。完成通知、状态查询和超时后的结果确认,都应围绕这些事实定义。
性能报告应同时给出连接更新规模、负载、并发、预热与配置准备条件,以及完整路径的均值和尾延迟。这样,不同协议、运行时与器件实现才能在相同终点下比较,调度器也才能据此安排下一阶段通信。前文分别测量 API 回复、新路径首个回包和切换空窗,正是为了区分这些系统效果。
回到开头:物理重构从20 ms降到200 μs,5 ms控制成本仍会把完整等待留在毫秒级。器件提速必须同时推动控制职责、软件路径和设备接口的调整,并通过应用可用的完整预算验收。 只有这条路径一起变快,应用才能用上器件进步带来的速度。
参考与阅读说明
核心研究文献
-
Mission Apollo: Landing Optical Circuit Switching at Datacenter Scale,第4.1节、图5与图8a:CPU、FPGA、高压驱动与 MEMS 反馈控制。
-
Jupiter Evolving: Transforming Google’s Datacenter Network via Optical Circuit Switches and Software-Defined Networking,SIGCOMM 2022:集中式 SDN、流量工程与拓扑工程的生产系统实例。
-
: A Programming Language for Silicon Photonics及公开编译器:程序编译与硬件映射。
-
Anuj Kalia、Michael Kaminsky、David G. Andersen,Datacenter RPCs can be General and Fast,NSDI 2019,第6.1节、表2:不同平台32 B RPC的中位延迟。
-
K. Sato,Optical switching will innovate intra data center networks,JOCN 16(1), A1–A23(2024):光交换架构的进一步阅读。
厂商与 OCP 社区材料
-
iPronics ONE-32 发布公告,2025-03-31:厂商给出的 <300 μs 重构指标。
-
iPronics B轮融资公告,2026-09-02:1.25亿美元,NVIDIA 参与。
-
Fast switching OCS for AI and Hyperscale Data Centers: Benefits, Technologies and Emerging Applications,James Burch、Vivek Sarathy,2026 OCP Global Summit:快速 OCS 用例、端到端指标与协同要求。
-
Optically-Accelerated AI Clusters Enabled by Interoperable Multi-Vendor OCSs: Use Cases and Opportunities,Iwan Kartawira、Kazuaki Ueda,Kazuya Anazawa 参与,2026 OCP Global Summit:CPO+OCS+SDN、工作负载优化与多厂商控制。
-
Zero-Touch OCS Fabrics for AI Scale-Out Infrastructure at Hyperscale,Kannan Raj、Michael DeMerchant:共同模型、服务语义、路径证明与闭环验证。
交换机软件架构
-
SONiC Architecture、基金会介绍、路由性能讨论及大型数据中心路由优化方案:生产应用、软件交接与特定场景的延迟量级。
-
Stratum Component Overview:P4Runtime/gNMI、交换机与芯片抽象、SDK 的分层。
规范
-
RFC 7950:YANG 1.1,第1、4节。
-
gNMI Specification,第3.4.2、3.4.3节:Set 回复与事务语义。
引用本文
如果本文对你有所帮助,欢迎引用。讨论交流请联系 wuchangbo@sii.edu.cn
@misc{wu2026ocscontrolarch,
  title = {{Microsecond Optical Switching. Millisecond Reality.}},
  author = {Wu, Changbo and Yu, Zhuolong},
  year = {2026},
  month = oct,
  howpublished = {ReconfigNet-Sim Blog},
  url = {https://zer0-nu1l.github.io/ReconfigNet-Sim/en/posts/ocs-control-arch/}
}