概要
在做网络应用的时候,往往会涉及到 QoS (Quality of Service)算法。
同时在应用平面,服务质量保证是非常重要的一环。
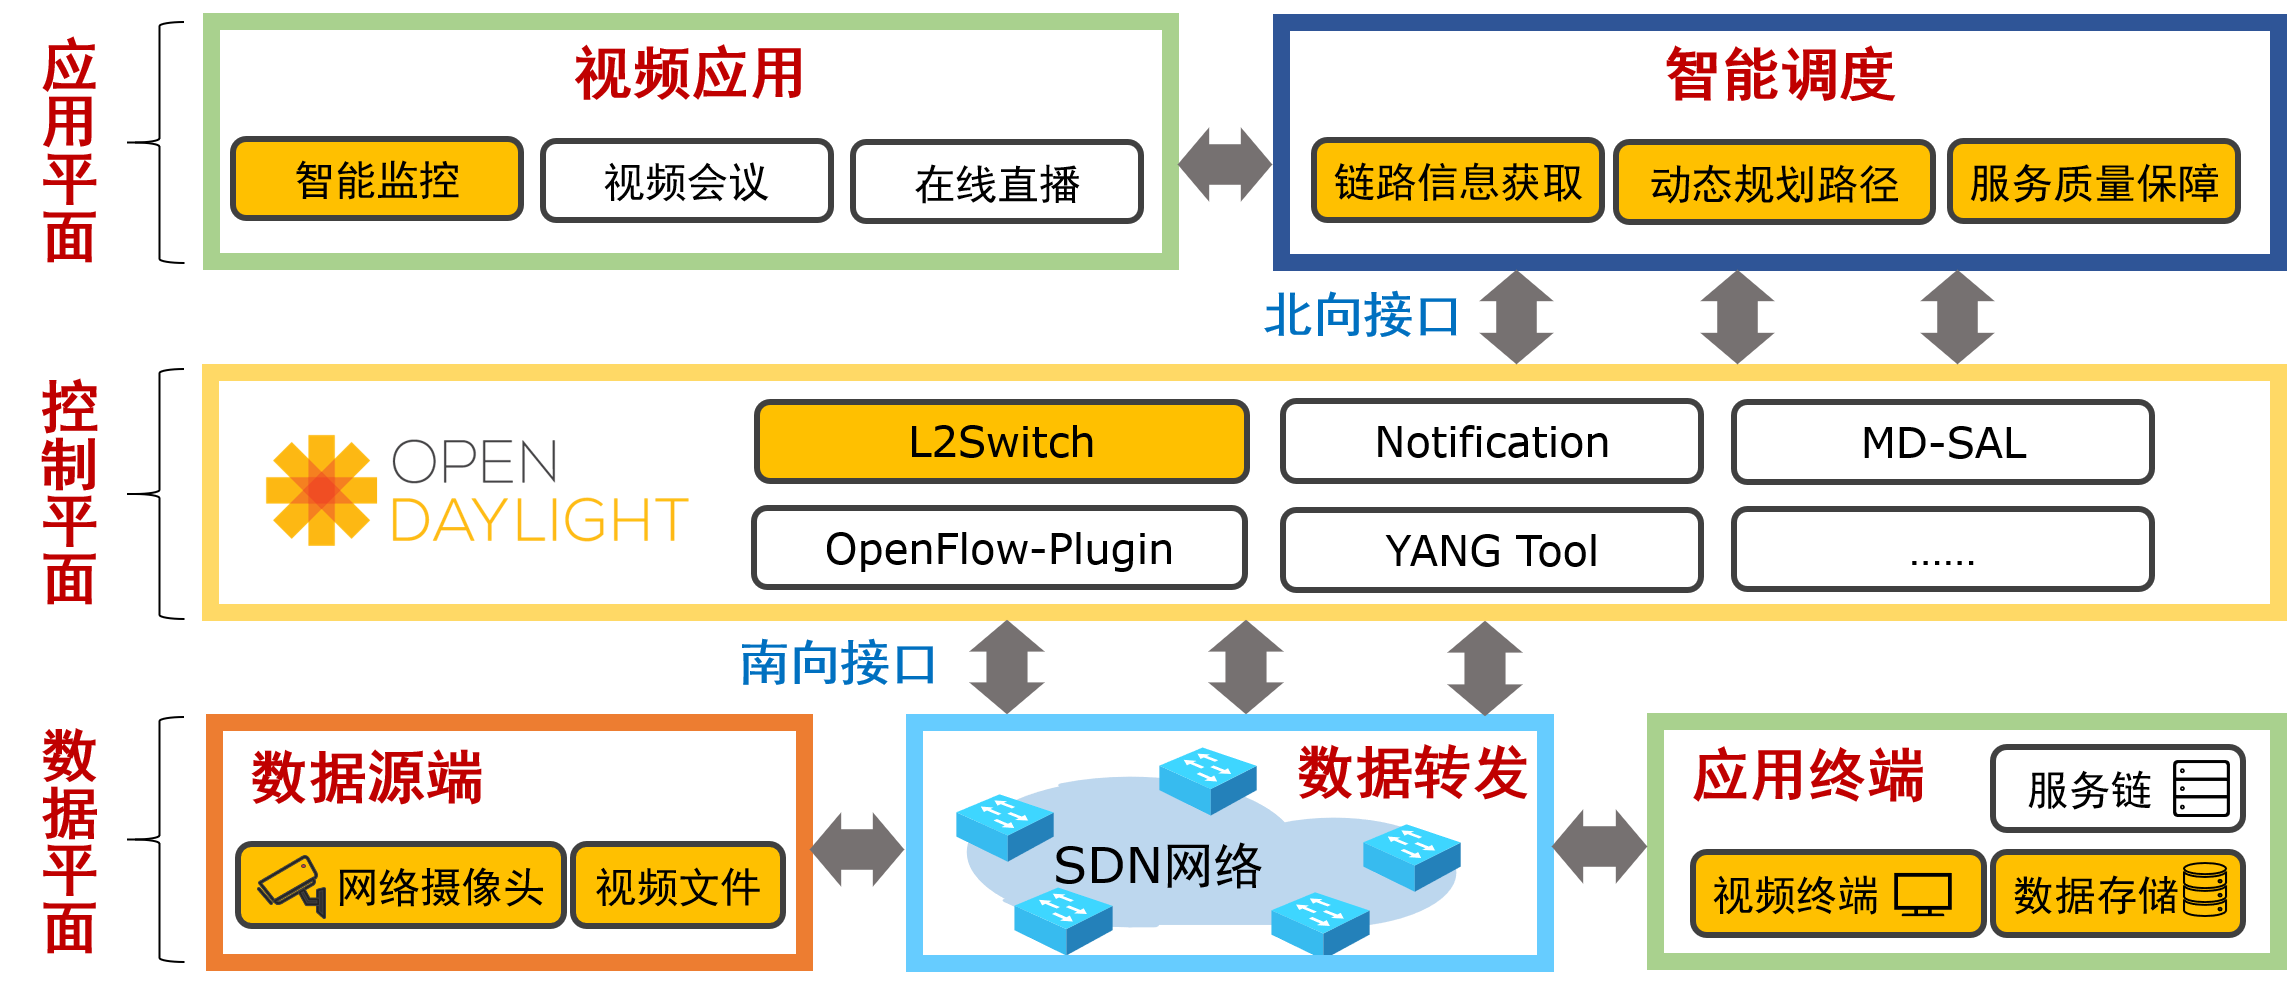
图0
学习的障碍主要在于:
- 没有系统地学习过运筹学(凸优化)等知识
- 论文中往往默认读者有相应的知识储备,对于一些可能比较关键的部分直接跳过。(都靠自己猜想和反推得到)
- 论文中有不少纰漏与缺憾。
这篇文章致力于以深入浅出的方式介绍 QoS 算法中的 基于拉格朗日松弛法的多约束 QoS 路由算法。
虽然对于论文中的一些部分没有吃透,但最重要的是通过整个过程,将 QoS 算法中默认读者储备的运筹学的知识展现出来。其中主要包括线性变换关系和次梯度。线性变换关系主要是为了将我们面对的网络路由算法抽象成数学问题,次梯度算法是为了找到最优解。
线性变换关系
这一部分对于后面将拉格朗日松弛法引入路由算法,以及从单约束路由算法扩展到多约束路由算法至关重要。
注:原本打算使用其他的例子,但是始终找不出比于建国博士举的更通俗例子,所以沿用之。
单因素积累单因素 - 标量×标量
加法是一种简单的计数模型。
现在考虑下面这种情况:有 3 只斑马,现在要计数每个斑马的眼睛。
经过九年义务教育的我们一定会不假思索用 $3 \times 2$ 来进行计算。这蕴含的是乘法的意义。
乘法是加法的“指数运算”,由加法迭代而成。
虽然上面的例子我们可以用原来的加法计数模型 6 次得到答案,但是我们很快发现每个斑马有 2 只眼睛,比例不变,于是乘法非常方便地计数这种单此累积量始终不变的加法 。
$$
y = w \times x
$$
在乘法式子中, y 表示因变量,是一种积累量,x 表示自变量,是一个积累因素,而 w 表示累计的速度。
对应之前的例子是:
$$
y(\text{眼睛总数量})
= a(\text{每个斑马的眼睛数量}) \times x(\text{斑马个数})
$$
多因素累积单因素 - 向量×向量
想知道斑马和小鸟共有多少只眼睛
现在出现了 2 个积累因素。
$$\begin{array}{cc}
y = w_1 \times x_1 + w_2 \times x_2 \\
x_1:\text{班马个数}, ; x_2:\text{小鸟个数}, ; y:\text{脚总数} \\
w_1:\text{斑马眼睛数量}, 4, ; w_2:\text{小鸟眼睛数量},2
\end{array}$$
想知道斑马、小鸟、老鼠、狮子……共有多少只眼睛
此时出现了多个积累因素,原来的乘法显得笨拙,也就出现了向量(vector)。
将不同因素按照固定顺序排列,用一个量来表示这些因素的整体。向量的维度对应因素的个数。
$$
x = (x_1, x_2, … x_n)
$$
回到刚刚的例子,
可用一个向量 $x=[x_1, x_2]$ 来代表斑马和小鸟分别有多少只;
再用一个向量 $w=[w_1, w_2]$ 来表示每个斑马和小鸟分有多少只腿。
注:之所以用字母 w ,是代表 weight 权重。
多因素累积多因素 - 矩阵×向量
不仅想要知道一共有多少个眼睛,还想知道有多少条腿时。
可以用两个有序排列的向量来代表两组权重,也就形成了矩阵。
$$
x=
\begin{bmatrix}
x_1 \\
x_2
\end{bmatrix} \tag{1}
$$
$$
W=
\begin{bmatrix}
w_1 \\
w_2
\end{bmatrix} =
\begin{bmatrix}
w_{11} & w_{12} \\
w_{21} & w_{22}
\end{bmatrix} \tag{2}
$$
$$
y=
\begin{bmatrix}
y_1 \\
y_2
\end{bmatrix} \tag{3}
$$
$$
b=
\begin{bmatrix}
b_1 \\
b_2
\end{bmatrix} \tag{4}
$$
$$
y = WX+b
$$
$$\begin{array}{cc}
x_1:\text{班马个数}, ; x_2:\text{小鸟个数} \\
w_{11}:\text{斑马眼睛数量} ; w_{12}:\text{小鸟眼睛数量}, ; y_1:\text{腿总数} \\
w_{21}:\text{斑马腿数量}, ; w_{22}:\text{小鸟腿数量}, ; y_2:\text{眼总数} \\
b_1:\text{积累前腿数量}, ; b_2:\text{积累前腿数量}
\end{array}$$
由于 W 和 b 这两个变量的作用是用于描述输入 x 和输出 y 之间的关系。也把它们统称为参数(parameters)。
批量多因素积累多因素 - 矩阵×矩阵
如果第一次看见了 3 个斑马和 1 只鸟,第二次看到了 4 个斑马和 1 只鸟。想要知道两次分别有多少条腿,还想知道有多少个眼睛。
就可以可以把所有(观察到的)x 并成矩阵来一次性批量计算。
在图像识别里,用会把一张图片切成一个行向量,然后由多个行向量组成一个矩阵。
通过矩阵运算就能实现图像的批量处理。
例子
应用实例: 职工轮训
实例某公司为了实现技术更新,计划对职工实行分批脱产轮训。
现有职工中不脱产职工8000人,脱产轮训职工2000人。
若每年从不脱产职工中抽调30%的人脱产轮训,同时又有60%脱产轮训职工结业回到生产岗位。
若职工总数保持不变,一年后不脱产职工及脱产轮训职工各有多少?两年后又怎样?
分析:
两个积累因素:不脱产职工人数和脱产轮训职工人数;
两个积累的权重:脱产轮训率和回归生产率;
$$
\left(
\begin{array}{ll}
{0.70} & {0.60} \\
{0.30} & {0.40}
\end{array}
\right)
\left(
\begin{array}{l}
{8000} \\
{2000}
\end{array}
\right)=
\left(
\begin{array}{l}
\text{不脱产的职工数} \\
\text{脱产的职工数}
\end{array}
\right)
$$
线性变化关系总结
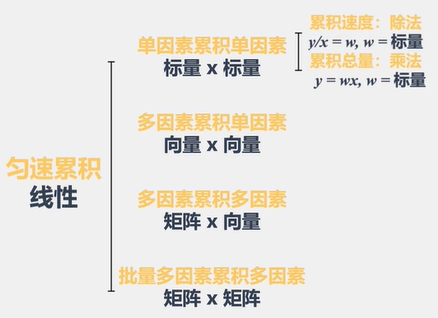
图1:匀速累积模型
---次梯度法
次梯度的概念
次导数(subderivative)、次微分(subdifferential)、次切线(subtangent lines)和次梯度(subgradient)的概念出现在凸分析,也就是凸函数的研究中。
梯度(导数)的概念大家都知道,次梯度可以说是对梯度的一种补充(次导数是对导数的一种补充)。因为有些函数是不可导的,比如前面的图 2 就是一个不可导的函数。
不妨从一元函数的图像理解,和导数一样,先做函数一个点的切线(和函数只有一个交点的直线)。但是不连续的函数可能有多个,这也意味着次导数有多个,或者说是处于一个区间。
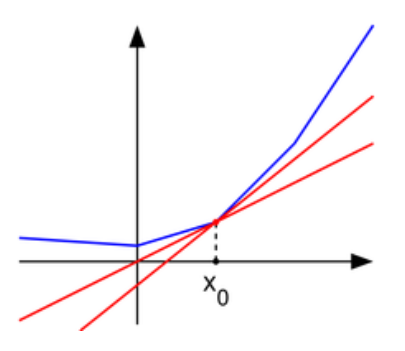
图2:次导数
图中蓝线表示函数,红线的斜率都在次导数的区间内。
点 $x_0$ 的次导数的集合是一个非空闭区间[a, b],其中 a 和 b 是单侧极限:
$$
\begin{aligned}
a=\lim_{x→x_{^-0}} \frac{f(x)−f(x_0)}{x−x_0} \\
b=\lim_{x→x{^+0}} \frac{f(x)−f(x_0)}{x−x_0}
\end{aligned}
$$
所有次导数的集合 $[a,b]$ 称为函数 $f$ 在 $x_0$ 的次微分。
例如:考虑凸函数 $f(x)=|x|$。在原点的次微分是区间 $[−1, 1]$ 。
$x_0<0$时,次微分是单元素集合{-1},而 $x_0>0$,则是单元素集合{1}。
同样的道理推广到多元函数就有次梯度的概念。
$$
f(x) \geq f\left(x_{0}\right)+g^{T}\left(x-x_{0}\right)
$$
导数或者梯度等于零的时候说明取到极值,对应地,如果次导数或者次梯度的区间范围内包含零,也就说明在改点取到极值。
$$
f \left(x^{* }\right)=\min_{x} f(x) \Leftrightarrow 0 \in \partial f\left(x^{*}\right)
$$
基本次梯度算法
参考维基百科:次梯度法
迭代方法
记 $f:\mathbb{R}^n \to \mathbb{R}$ 为定义在 $\mathbb{R}^n$ 上的凸函数。
次梯度算法使用以下的迭代格式:
$$
x^{(k+1)} = x^{(k)} - \alpha_k g^{(k)}
$$
其中 $g^{(k)}$ 表示函数 $f$ 在 $x^{(k)}$ 的次梯度. 如果 $f$ 可微,他的次梯度就是梯度向量$\nabla f$.
有时,$-g^{(k)}$ 不是函数 $f$ 在 $x^{(k)}$ 处的下降方向。因此采用一系列可能的 $f_{\rm{best}}$ 来追踪目标函数的极小值点,即:
$$
f_{\rm{best}}^{(k)} = \min {f_{\rm{best}}^{(k-1)} , f(x^{(k)}) }
$$
步长的选取
与梯度下降算法不同的是:次梯度算法没有明确的步长选择方法,有许多可采用的步长。以下为5种能够保证收敛性的步长规则:
- 恒定步长,$\alpha_k = \alpha$。
- 恒定间隔,$\alpha_k = \gamma/\lVert g^{(k)} \rVert_2$,得出$\lVert x^{(k+1)} - x^{(k)} \rVert_2 = \gamma$。
- 步长平方可加,但步长不可加,即步长满足:
$\alpha_k\geq0,\qquad\sum_{k=1}^\infty \alpha_k^2 < \infty,\qquad \sum_{k=1}^\infty \alpha_k = \infty$。 - 步长不可加但步长递减,即步长满足:
$\alpha_k\geq0,\qquad \lim_{k\to\infty} \alpha_k = 0,\qquad \sum_{k=1}^\infty \alpha_k = \infty$。 - 间隔不可加但间隔递减,即$\alpha_k = \gamma_k/\lVert g^{(k)} \rVert_2$,其中:
$\gamma_k\geq0,\qquad \lim_{k\to\infty} \gamma_k = 0,\qquad \sum_{k=1}^\infty \gamma_k = \infty$。
注意:上述步长是在算法执行前所确定的,不依赖于算法运行过程中产生的任何数据。这是与标准梯度下降法的显著区别。
停止条件
这一部分维基百科没有说明。我也是打算放进我们后续的算法中说明,因为后续的算法的场景更小,停止条件更有针对性。对这方面有兴趣的也可以自行学习。
拉格朗日松弛法(Lagrange Relaxation)
要解决的问题
拉格朗日松弛应用于求解约束规划问题。
数学描述为:
$$
\begin{aligned}
z_{1}= \min c^{T} x \\
s.t. Ax \geq b \\
x\in Z_{+}^{n}
\end{aligned}
$$
其中 $z_{1}=\min c^{T} x$ 是没有约束条件时的最小值,但现在有了 $Ax \geq b$ 这样的约束条件,原来的最优解不一定会满足约束条件。
扩展
我们可以对 x 的取值进行合理扩展。原式子中有 $x\in Z_{+}^{n}$,我可以把它扩展成多个因素,也就是向量 $x=[x_1, x_2, …, x_n]^T$。(从运筹学教材中广泛使用向量、矩阵得到的灵感)
而 $c=[c_1, c_2, …, c_n]$,c 可以理解成 const 或者 cost(代价)。
基本原理
基本思想
拉格朗日松弛是求解下界的一种方法。核心的思想是将造成问题难的约束吸收到目标函数中,使问题容易求解。
将 $Ax \geq b$ 变成 $0 \geq b - Ax$ 乘上拉格朗日乘子(非负)$ \lambda ^T$,加入到 $z_{1}=\min c^{T} x$ 中,即构成拉格朗日松弛式:
$$
z_{LR}( \lambda )=\min c^{T} x+\left( \lambda ^{T}\right)(b-A x)
$$
由于 $b - Ax \leq 0$,所以 $ z_{LR}( \lambda ) \leq z_{IP} $。其中 $z_{IP}$ 表示 LR 的一个可行解。
此时,原理的问题求解变成了选择最优的拉格朗日乘子。
选择最优的拉格朗日乘子
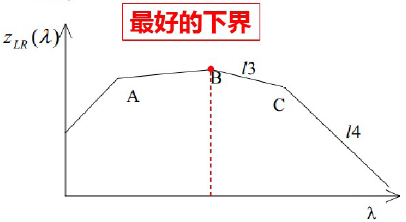 图2:拉格朗日松弛式函数图像
$z_{LR}( \lambda )$ 是一个凹函数(向上凸)。(对应的,向下凸为凸函数)
如果它是光滑的(可微),就用梯度法来寻找最优的拉格朗日乘子;
如果它是非光滑的(不可微),就用次梯度法来寻找最优的拉格朗日乘子;
梯度法
梯度法简单介绍,因为这篇文章后续应用的是次梯度法。
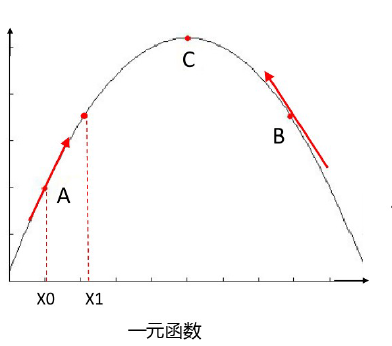
图3:一元函数梯度下降
基本步骤:任给一个初始出发点,设为X0,
- 设定一个步长d;
- 计算该点当前梯度(导数)$y’$;
- 修改当前参数$x_1=x_0+d*y’$
- 计算该点当前梯度(导数)$y’$;
…重复…
当然有很多优化的梯度下降法,这里从略。
次梯度法
之前已经介绍过次梯度的概念。
需要解决的问题是步长的选择和停止条件。
步长的选择
虽然前面列举了若干种方法,但在 Stanford University 的课程中提到了一种很适合的步长选取方法(Polyak’ rule):
$$
\begin{array}{l}
{\text { Optimal step size when } f^{ \star } \text { is known }} \\
{\text { choice due to Polyak: }} \\
{\qquad \alpha_{k} = \frac{ f\left(x^{(k) }\right) - f^{ \star } }{ \left|g^{(k)}\right| _{2}^{2} } } \\
{\text { (can also use when optimal value is estimated) }}
\end{array}
$$
$$
\begin{array}{l}
{\text { motivation: start with basic inequality }} \\
{\qquad \left| x^{ (k+1) } - x^{ \star } \right| _{2} ^{2} \leq \left | x^{(k)} - x^{ \star } \right| _{2}^{2} - 2\alpha _{k} \left (f \left(x^{ (k) } \right) - f^{ \star } \right) + \alpha_{k}^{2}\left| g^{ (k) }\right| _{2}^{2}} \\
{\text { and choose } \alpha _{k} \text { to minimize righthand side }}
\end{array}
$$
…
…
(后续还有很多,没有搬过来,有兴趣可以自己查阅)
若是最优值 $f(x^*)$ 可知则可以用这种方法。
其中 ${\left| g^{(k)} \right|_{2}}$ 称为欧几里得范数,表示从原点出发到向量 $x$ 确定的点的欧几里得距离。也就是:
$$
|x|_{2} = \left(\ sum_{i} \left| x_{i} \right| ^{2} \right) ^{ \frac{1}{2} }
$$
欧几里得范数在机器学习中出现地十分频繁,经常省略下标2,简写成${\left|x\right|}$,所以这里的步长很多地方也在写作:
$$
\alpha_{k} = \frac{ f\left(x^{k} \right) - f \left( x^{*} \right)}{ \left| g^{k} \right| ^{2}}
$$
停止条件
- 迭代次数不超过$T$。这是一种最为简单的原则,但解的质量无法保证。
- $s^t=0$ 。这是最为理想的状态,此时,达到拉格朗日对偶的最优解。
在实际计算中,由于问题的复杂性和计算机本身的计算误差,这样的结果难达到,常常用$||s^t|| \le \epsilon$(c为给定的非负数)来代替。 - $z_{UP}(t)=z_{LB}(t)$。在 $z_{UP}(t)$ 和 $z_{LB}(t)$ 可变时,这种情况表示已得到原问题的最优解。最优解为 $z_{IP}=z_{UP}(t)=z_{LR}(t)$.
- $ \lambda ^t$或者目标值 $z_{LR}( \lambda ^t)$ 在规定的步数内变化不超过一个给定的值。
应用次梯度法于拉格朗日松弛
构造的拉格朗日松弛式为:
$$
z_{LR}( \lambda )=\min c^{T} x+\left( \lambda ^{T}\right)(b-A x)
$$
由于次梯度是不唯一的,所以选择其中一个即可。
算法步骤:
- 任选一个初始拉格朗日乘子 $ \lambda ^1, t=1.$
- 对 $ \lambda ^t$,任选一个次梯度 $s^{i}$;若 $s^{i}=0$,则 $ \lambda ^t$ 达到最优解而停止计算。否则 $ \lambda ^t = max[ \lambda ^t + \theta_t s^t, 0 ]$, t = t+1,重复迭代。
这里选取 $s^{i}=b-A x^{i}$ 作为梯度。
$i$ 表示第 $i$ 次迭代,$x^i$ 表示 $z_{LR}( \lambda )$ 的一个可行解。
步长 $\theta_t$ 依照前面的 Polyak 准则:
$$
\theta_{t} = \frac{ z_{UP}(t)-z_{LR}(t) }{\left| s^{t} \right| ^{2}} \beta_{t}
$$
$z_{UP}(t)$ 为原问题的一个上界,可以由一个可行解的目标值确定,也可以通过估计的方法得到。
可随 t 的变化逐步修正。
$z_{LR}(t)$为问题的下界,取 $z_{UP}(t)=z_{LR}(t)$.
$0 \le \beta_t \le 2$,一般取 $\beta_0 =2$。
当 $z_{LR}(t)$ 上升的时候,$\beta_t保持不变$;
当 $z_{LR}(t)$ 在给定的若干步没有变化时,取其 $\frac{1}{2}$.
简单应用
在网络上流传的一份拉格朗日松弛算法的课件里面有一道简单应用,可以作为巩固理解的练习题,由于没有加入任何笔者的个人理解,这里不做搬运工了。
参看百度文库里的一个课件:拉格朗日松弛
用途
- 对于线性整数规划问题,将难约束吸收到目标函数后,问题变得容易求解。虽然不一定是可行解,但是可以求得下界。
- 实际的计算结果证实拉格朗日松弛方法所给的下界相当不错,且计算时间可以接受。可以用于拉格朗日松弛的启发式算法(也就是我们马上就会用到的)。认为目标值不可能再变化,因此,停止运算。
QoS
终于到了 QoS 算法,不过不用担心,如果前面的部分已经理解,后面的除了论文有很多坑以外,已经没有太多比较难理解的了(可能吧)。
QoS 和 拉格朗日松弛法的关系
QoS 问题简介
服务质量(QoS)是计算机网络研究领域的一个热点问题,目的是为用户在网络中搜索满足业务需求的路径。
QoS 路由的度量参数包括带宽、代价、延迟、延迟抖动、丢失率和跳数等。根据运算规则, 这些度量参数可分为加性度量参数、乘性度量参数和凹性度量参数。QoS 度量参数中, 代价、延迟等属于加性度量参数, 丢失率属于乘性参数, 带宽属于凹性参数。搜索 QoS 路径过程中, 可以删除不满足凹性参数的链路, 而乘性参数可通过取对数变为加性参数, 所以 QoS 路由算法主要是搜索到满足一个或多个加性度量参数的路径。
已经能证明多个加性度量的QoS 路由问题属于 NP 完全问题。
—— 《基于拉格朗日松驰的多约束QoS路由算法》
传统算法和拉格朗日松弛法
Dijkstra 算法是最短路径算法中的比较经典的算法,但只适用于求解单维权重图,对于多维权重图
的多约束路径问题,Dijkstra 算法难以胜任。拉格朗日松弛法是求解组合优化问题的常用方法,其基本思想是将约束条件吸收到目标函数中,使目标函数仍保持线性,并使得问题容易求解,从而可以在多项式时间内求出最优解或可行解。
——《一种基于拉格朗日松弛法的QoS路由算法》
论文介绍
最开始拿到的论文是 [1]何涛,王锁萍,张明.一种基于拉格朗日松弛法的QoS路由算法[J].电路与系统学报,2010,15(01):37-40.,起初觉得这篇论文提出拉格朗日松弛的文字还是蛮流畅的,但是到 4.1 算法相关的结论与证明 部分,就觉得有点奇怪了,虽然它的证明没有太大问题,但是形式上已经和我所理解的拉格朗日松弛开始脱节。
论文缺憾
- 它的拉格朗提松弛式构造成了:$d§-\Delta_{\text {delay}}+ \lambda c§ $,也就是把要求解的最小代价吸附到约束条件上,这个思路和正常的拉格朗日松弛式相反的;虽然如果运算的时候把他构造的式子两边同除以 $ \lambda $,把 $ \lambda $ 当成原来的 $\frac{1}{ \lambda }$,会回到正常的拉格朗日松弛式,但是又何必如此大费周章?后来找了很多其他论文,也证明了他们的思路和我都是一致的。
- 这篇论文的第二个遗憾是除了文字表面提了拉格朗日松弛,在算法实现步骤中并看不出来是拉格朗日松弛,确认极值的时候也是用自己证明的一些定理。最让我感到困惑的是在算法分析部分“故每次迭代后的路径总是优于上次迭代的结果”的理由不能让我信服。
- 最后一个的缺憾,私以为是算法步骤中的数学符号没有加以说明,难以理解。在文章前面部分数学符号的解释的位置放得恰到好处,而这一部分并没有处理得那么优秀。
IEEE 论文
之后找到了另一篇论文 [1]Juttner, A., Szviatovski, B., Mecs, I., Rajko, Z.. Lagrange relaxation based method for the QoS routing problem[P]. INFOCOM 2001. Twentieth Annual Joint Conference of the IEEE Computer and Communications Societies. Proceedings. IEEE,2001.,
两个事情让我很震惊。
第一个是之前看到的论文和这一篇近似度极高…… 而这篇论文发表比前一篇早大概 9 年。并且我不觉得前一篇论文相对这一篇论文有什么创新,还缺乏了不少内容,甚至很有必要的说明部分略去了。
另外一件事是这篇 IEEE 论文也有一些谬误。
-
在
III. PROPOSED ALGORITHM C. Running time of the algorithm部分,符号的下标写错了:
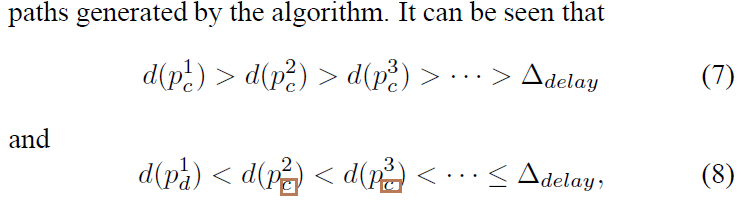
-
在
III. PROPOSED ALGORITHM B. The description of the algorithm部分,也有疑似纰漏的地方:
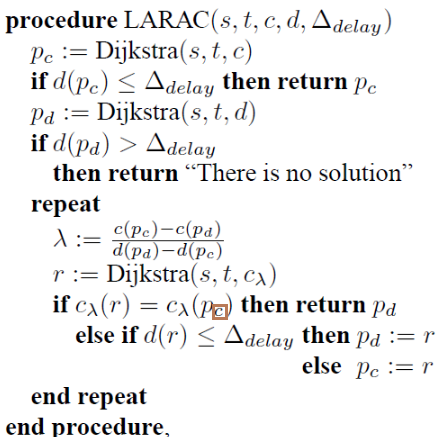
虽然 IEEE 论文有瑕疵,但是后续的会以它的为主,第一篇信誉度下滑的中文论文暂且放下。
邹永贵等:带多约束条件的最优路径选择算法研究 中对我最大的启示不是论文本身提出的观点,而是它提到了这篇 IEEE 论文中确确实实是采用次梯度下降法寻找最优参数,并采用上下界相等的停止原则来获得最优的解
数学抽象
现在要做的就是用前面介绍的线性变换关系,将 QoS 算法抽象成原来的拉格朗日松弛技术下的数学表达。
这一步在论文中都是跳过的,笔者猜想这是默认阅读论文的人都是学过运筹学或者最优化理论的。作为深入浅出的博客文章,我会对加上这一部分进行介绍。
最值问题
原本的拉格朗日松弛法解决的问题是:
$$
\begin{aligned}
z_{1}= \min c^{T} x \\
s.t. Ax \geq b \\
x=[x_1, x_2, …, x_n]^T
\end{aligned}
$$
其中 $x$ 是一个列向量,这是之前讨论的结果,也是为这里的工作埋下的伏笔。
前面提到的把 $c=[c_1, c_2, …, c_m]$,字母c 可以理解成 cost(代价),也是伏笔。
图
网络可以看成是一张图,每一个结点V(vertex)对应一个网络设备或是终端,边(Edge)的权重对应连路上的一些参数,比如时延(delay)、代价(cost)。之前也提到乘性参数可通过取对数变为加性参数,所以可以统一处理。
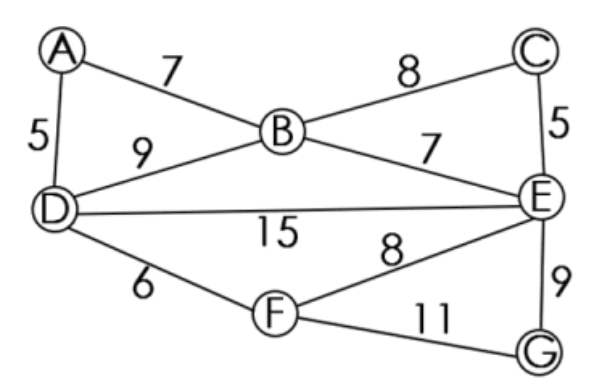
最小代价和时延约束
而从一个结点到另一个结点的最小代价可以用图论中的 Dijkstra 算法得到。最短路径 $p$ 可以用一个列向量表示,为了和参数(比如代价)元素个数保持一致,路径用边作为向量的元素。故:最短路径 $p = [e_1, e_2, …, e_m]$,路径上的边权 $c=[c_1, c_2, …, c_m]$。现在得到一个非常重要的式子,通过多因素积累单因素得到所有边权的总和:
$$
c^T p = \min _{p \in P^{\prime}(s, t)} \sum_{e \in p} c(e) = Cost
$$
$P^{\prime}(s, t)$表示从结点 s,到结点 t 所有的路径。
同样的道理,时延可以表示成为:
$$
d^T p = \sum_{e \in p} d(e) = Delay
$$
原来的时延约束条件对应的表达式为:
$$
\sum_{e \in p} d(e)\le \Delta_{delay}
$$
总的来说,已经将时延约束下最小代价的 QoS 转成适用于拉格朗日松弛法的表达式子。
$$
\begin{aligned}
z_{1}= \min c^{T} x \Rightarrow \min _{p \in P^{\prime}(s, t)} \sum_{e \in p} c(e) \\
s.t. Ax \geq b \Rightarrow \sum_{e \in p} d(e)\le \Delta_{delay}\\
x=[x_1, x_2, …, x_n]^T \Rightarrow p = [e_1, e_2, …, e_m]
\end{aligned}
$$
多约束条件
多约束条件是类似的。
$$
\begin{array}{c}{\min c§} \\
s.t. \\
w_{1}§ \leqslant M_{1} \\
{w_{2}§ \leqslant M_{2}} \\
{\vdots} \\
{w_{k}§ \leqslant M_{k}}\end{array}
$$
基于拉格朗日松弛的 QoS
原始问题的困难点在于代价和时延没有关系,所以要找到满足时延条件的代价最小的路径,只能把全部路径遍历一遍。是 NP 完全问题。
构造拉格朗日松弛式及其性质
Claim 1
$$
\begin{array}{l}
{\text { Claim 1: Let }} \\
{\qquad L( \lambda ):=\min \left[ c_{ \lambda }§: p \in P(s, t)\right]- \lambda \Delta_{\text {delay }}} \\
{\leq c - \lambda \left(p^{* }\right)- \lambda \Delta_{\text {delay}}} \\
{= c\left(p^{* }\right)+ \lambda \left(d\left(p^{* }\right)-\Delta_{\text {delay}}\right) \leq c\left(p^{*}\right)}
\end{array}
$$
这个 claim 告诉我们两个事情。
第一个事情是(第一行):
$$
\begin{aligned}
\min _{p \in P^{\prime}(s, t)} \sum_{e \in p} c(e) - \lambda (\sum_{e \in p} d(e) - \Delta_{delay})\\
\Rightarrow L( \lambda ) = c_§ - \lambda (d§-\Delta_{delay})
\end{aligned}
$$
$L( \lambda )$ 就是之前的 $z_1( \lambda )$.
虽然矩阵乘法的意义没有变,但是 $ \lambda \not= 0$ 时,$c_{ \lambda }§$ 对应的已经不是原本意义下的最小代价或者时延。解释如下:
$$
L( \lambda ) = c_§ - \lambda (d§-\Delta_{delay}) = (c_§ - \lambda d§) - \lambda \Delta_{delay}
$$
$$
\begin{array}{l}{
\text { 令 }}
(c_§ - \lambda d§)=c_{ \lambda }
\text{,则}
L( \lambda ):=\min \left\{c_{ \lambda }§: p \in P(s, t)\right\}- \lambda \Delta_{delay}
\end{array}
$$
这意味着拉格朗日松弛式构造的函数 $L( \lambda )$ 中的 $c(p_{ \lambda })$ 对应的边的权重是由原来的代价和时延按照 $ \lambda : 1$ 混合而成。(其实如果对拉格朗日松弛法熟悉的人早就看透了这一点)。
第二个事情(不等号放缩):
通过不等式放缩得到了 $L_{ \lambda }$ 的上界,这成为后面选用 Polyak’ rule 作为步长选取的方案做了铺垫。
Claim 2
$$
\begin{array}{l}
{\text { Claim 2: } L \text { is a concave piecewise linear function, namely }} \\
{\text { the minimum of the linear functions } c§+ \lambda \left(d§-\Delta_{\text {delay}}\right)} \\
{\text {for all } p \in P(s, t) .}
\end{array}
$$
concave piecewise linear function: 凹分段线性函数
这个也告诉我们两件事情,一个是作为分段线性函数,寻找 $ \lambda $ 的方法是用次梯度下降法,而非梯度下降法。在没有看这篇文章的时候我曾经选用了梯度法(无法求导)。另一件事情是它是凹函数,所以在用“次梯度下降法”(这里也许可以称为是次梯度上升法),注意是往次梯度上升的方向靠近,不要思维定式地下降。
Claim 3
$$
\begin{array}{l}{\text { Claim 3: For any } \lambda \geq 0 \text { and } c_{ \lambda } \text { -minimal path } p_{ \lambda }, d\left(p_{ \lambda }\right) \text { is a }} \\ {\text { supgradient of } L \text { in the point } \lambda .}\end{array}
$$
这个 claim 告诉我们一个非常非常重要的事情,它直接把一个合适的次梯度告诉我们了:$d(p_{ \lambda })$.
有兴趣的可以证明一下。
Claim 4
$$
\begin{array}{l}
{\text { Claim 4: Whenever } \lambda < \lambda ^{* }, \text { then } d\left(p_{ \lambda }\right) \geq \Delta_{\text {delay}} and , if } \\
{ \lambda > \lambda ^{*}, \text { then } d\left(p_{ \lambda }\right) \leq \Delta_{\text {delay }} \text { for each } c_{ \lambda \text { -minimal path } p_{ \lambda }}}
\end{array}
$$
实话是,我在写这篇文章的时候才理解它想表达的意思。(现在都还没有懂)
其中$L^{* }:=\max _{ \lambda \geq 0} L( \lambda ), \lambda ^*$是使该式子成立的一个参数。
既然 $L( \lambda )$ 中的 $c(p_{ \lambda })$ 对应的边的权重是由原来的代价和时延按照 $ \lambda : 1$ 混合而成,那么我们可以想象得到最优解在,差不多刚刚好满足时延条件下时的最小代价。如果 $ \lambda $ 过小,$c(p_{ \lambda })$ 会因为时延部分给的太少而不够大;如果 $ \lambda $ 过大,拉格朗日乘子和乘数的乘积会很小(负数),所以是一个凹函数。
$ \lambda $
Claim 5
$$
\begin{array}{l}{\text { Claim } 5: \text { A value } \lambda \text { maximizes the function } L( \lambda ) \text { if and only }} \\ {\text { if there are paths } p_{c} \text { and } p_{d} \text { which are both } c_{ \lambda } \text { -minimal and for }} \\ {\text { which } d\left(p_{c}\right) \geq \Delta_{\text {delay}} \text {and } d\left(p_{d}\right) \leq \Delta_{\text {delay}} }\end{array}.
$$
claim 5 告诉我们存在最小解 λ 的充要条件是:最小时延小于限制条件并且最小代价的时延大于等于时延(否则不需要松弛了即有最优解)。
最小时延和最小代价可以发生在一条路径上。
(这个定理千万千万不要误会不要误会)
Claim 6
$$
\begin{array}{l}
{\text { Claim } 6: \text { Let } 0 \leq \lambda_ {1}< \lambda_ {2}, \text { and } p_{ \lambda_ {1}}, p_{ \lambda_ {2}} \in P(s, t) \lambda_ {1}-} \\ {\text { minimal and } \lambda_ {2} \text { -minimal paths. Then } c\left(p_{ \lambda_ {1}}\right) \leq c\left(p_{ \lambda_ {2}}\right) \text { and }} \\ {d\left(p_{ \lambda_ {1}}\right) \geq d\left(p_{ \lambda_ {2}}\right)}
\end{array}
$$
λ 增加,意味着时延的要求更高。满足条件的最优路径,原本的时延会变小,代价会增大。
所以随着 λ 增加,原本路径代价变化,时延小的路径的总体代价逐渐减小,晋升为代价最小路径。
算法流程
完事具备,只欠东风:
$$
\begin{array}{l}
{ \text { procedure LARAC( }\left.s, t, c, d, \Delta_{\text {delay }}\right)} \\
{p_{c}:=\text { Dijkstra }(s, t, c)} \\
{\text { if } d\left(p_{c}\right) \leq \Delta_{delay}\text { then return } p_{c}} \\
{\left.p_{d}:=\text { Dijkstra } (s, t, d\right)} \\
{\text { if } d\left(p_{d}\right)>\Delta_{\text {delay }}} \\
{\text { then return “There is no solution”}}\\
{\text { repeat }} \\
{ \begin{aligned}
\lambda &:=\frac{c\left(p_{c}\right)-c\left(p_{d}\right)}{d\left(p_{d}\right)-d\left(p_{c}\right)} \\
{r:=\text { Dijkstra }(s, t, c_{ \lambda })} \\
\text { if } c_{ \lambda }®=c_{ \lambda }\left(p_{d}\right) \text { then return } p_{d}\\
\text { else if } d® \leq \Delta_{delay}\text { then } p_{d}:=r \\
\text {else} ; p_c := r\\
{\text { end repeat }}\\
\text { end procedure }
\end{aligned}}
\end{array}
$$
where Dijkstra(s,t,c) returns a c-minimal path between the nodes s and t.
解读
特殊情况处理
根据前面的 claim 5,排除了最小时延大于限制条件的情况。同时如果在在最小代价的情况下已经满足时延条件,那就不必用拉格朗日松弛法,直接输出。
次梯度下降法
根据 Claim 2,我们知道 $L( \lambda )$ 是凹分段线性函数;根据 Claim 1,我们知道 $L( \lambda )$ 的上界是任意的一条路径的代价 $c(p^* )$. 在知道上界的情况下,我们自然想到用 Polyak’ rule。
步长为:
$$
{\qquad \alpha_{k} = \frac{ f \left(x^{(k)} \right) - f^{ \star }}{ \left| g^{(k)} \right| _{2}^{2}}}
$$
从算法流程中我们可以看出来,这里取的路径 $p^*$ 是最小时延路径 $c(p_d)$.
根据 claim 3,取 $d(p_{ \lambda })$ 作为一个合适的次梯度.
// 之后那么 $ \lambda $ 怎么用那个公式反复迭代至今没有推送算出来,但是八九不离十。
最终结束的条件是我们在介绍拉格朗日松弛法停止原则的第三条,上界等于下界。这里的上界是最小时延路径 $c(p_d)$,下界是每次 $L( \lambda )$ 的一个可行解。
带多约束条件
在 邹永贵等:带多约束条件的最优路径选择算法研究 中对Dijksra算法进行了适当的改进, 定义了一个选取规则, 从而使算法接近最优解。
先用拉格朗日松弛消去约束, 并求得问题的下界。由于常用的迭代方法效果不好, 提出了一种新的迭代方法。
参考材料
参考文献
[1]Juttner, A., Szviatovski, B., Mecs, I., Rajko, Z… Lagrange relaxation based method for the QoS routing problem[P]. INFOCOM 2001. Twentieth Annual Joint Conference of the IEEE Computer and Communications Societies. Proceedings. IEEE,2001.
[2]何涛,王锁萍,张明.一种基于拉格朗日松弛法的QoS路由算法[J].电路与系统学报,2010,15(01):37-40.
[3]查益,江昊,晏蒲柳,周建国,周小平,徐武平.基于拉格朗日松驰的多约束QoS路由算法[J].计算机应用研究,2005(01):47-49.
[4]Winston,W.L.运筹学:数学规划(第3版)[M].北京:清华大学出版社,2004.01
[5]黄廷祝,成孝予.线性代数与空间解析几何(第四版)[M].高等教育出版社,2015.09
参考网页
- 7分钟带你入门线性代数+微积分
- 什么是次梯度(次导数)
- 拉格朗日松弛
- 【机器学习】次梯度(subgradient)方法
- subgrad_method_slide - Stanford University